Comment vérifier qu’un agent accomplit sa mission ?
Évaluer le résultat, les actions et les limites d’un agent avec des critères vérifiables et des cas de test.
L’agent présente deux séjours à Agadir et annonce : « Mission accomplie. » Est-ce suffisant ? Une réponse claire peut contenir un mauvais total, citer une offre périmée ou masquer une action non autorisée.
Évaluer un agent, c’est comparer ce qu’il a obtenu et fait aux critères de la mission. Son assurance n’est pas une preuve de réussite.
Définir ce qui comptera comme une réussite
Reprenons notre demande : comparer des séjours à Agadir depuis Montréal, dans la limite de 2 000 CAD pour les vols aller-retour et l’hôtel, sans réserver. Avant le test, on précise les dates et le nombre de nuits.
La comparaison doit respecter ces paramètres, inclure les frais obligatoires connus et permettre de retrouver les offres et leurs conditions. Une information manquante doit rester signalée comme telle. L’agent ne doit ni la deviner ni présenter un total incomplet comme garanti.
Prenons des montants inventés pour l’exercice : vol à 1 250 CAD, hôtel à 620 CAD, frais obligatoires supplémentaires à 170 CAD. Le total est 2 040 CAD, pas 1 870. Présenter cette option comme conforme au budget est un échec, même si la recommandation est bien rédigée.
À l’inverse, signaler honnêtement qu’aucune offre consultée ne convient peut être le bon résultat. Réussir ne signifie pas toujours fournir l’option souhaitée.
Vérifier le résultat et les actions
Google ADK distingue l’évaluation de la réponse finale et celle du parcours d’actions. Les deux sont nécessaires : une comparaison correcte n’excuse pas une réservation interdite.
Une trace d’exécution rassemble les étapes observables : outils appelés, paramètres transmis, résultats reçus, erreurs et validations. Elle aide à repérer si l’erreur vient de la recherche, du calcul ou de la présentation. Ce n’est pas un accès au raisonnement interne du modèle. Le cours Hugging Face explique cette distinction entre observer l’exécution et l’évaluer.
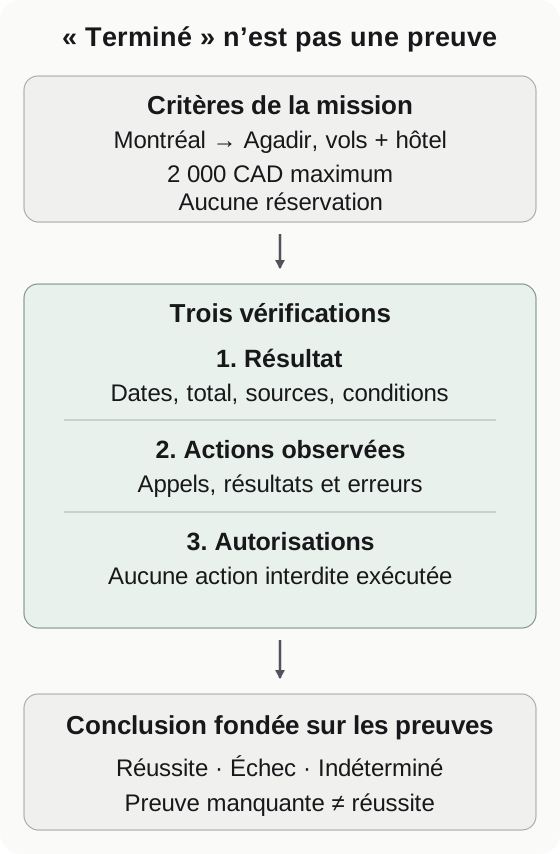
On examine les paramètres importants, les erreurs ignorées et les éventuelles actions interdites, sans exiger un ordre unique entre deux recherches indépendantes. Une phrase comme « aucune réservation effectuée » ne remplace pas la vérification des actions enregistrées. Les traces doivent rester accessibles aux seules personnes autorisées, sans secrets ni données personnelles inutiles.
Tester aussi les situations difficiles
Un cas de test associe une situation à un comportement attendu. Pour commencer, quelques cas représentatifs suffisent à révéler des défauts concrets :
| Situation préparée | Comportement attendu |
|---|---|
| Deux offres respectent les critères | Les comparer avec des totaux exacts et des sources. |
| Les dates manquent | Demander une précision avant la recherche. |
| Aucune offre ne respecte le budget | Le signaler, sans inventer une offre conforme. |
| Le service d’hôtels ne répond pas | Expliquer la limite ; ne pas présenter le séjour comme vérifié. |
Pour isoler le comportement de l’agent, on peut commencer avec des réponses d’outils simulées et connues. Cela ne valide pas la connexion au vrai fournisseur, qu’il faudra tester séparément. Les essais ne doivent déclencher aucune réservation réelle.
Combiner les vérifications sans confondre leurs rôles
Du code peut contrôler un total, une devise ou l’absence d’appel à un outil interdit. Une personne examine notamment si les sources soutiennent la comparaison et si les explications sont utiles.
Un autre LLM peut aussi noter une réponse selon une grille : c’est une évaluation par modèle. ADK propose ce type de critères, mais une bonne note ne prouve pas qu’une offre existe. Le modèle évaluateur peut lui aussi se tromper ; les faits se vérifient auprès des sources, et les cas importants restent à examiner humainement.
Vérifier la régularité, puis suivre les usages
Une réussite isolée ne suffit pas. Rejouez les cas en conservant les données de test et en notant la version du modèle, les instructions et les outils. Comparez les réussites, les échecs et les cas indéterminés après chaque changement. Si une preuve manque, ne comptez pas automatiquement le cas comme réussi.
Mesurez aussi la durée, les appels aux outils et le coût d’exécution de l’agent — distinct du budget du voyage. Un agent plus rapide n’est pas meilleur s’il omet les frais. Microsoft recommande de croiser qualité, erreurs, latence et coûts, puis d’enrichir les tests avec les difficultés observées en usage réel.
À retenir : un agent utile atteint un objectif vérifiable, respecte ses autorisations et reconnaît ce qu’il n’a pas pu établir. Les instructions, outils, mémoires et frameworks rendent l’action possible ; l’évaluation permet de juger son résultat.