3. Comment le modèle construit-il une réponse ?
Comprendre comment les probabilités et les choix successifs de tokens permettent de construire une réponse, sans en garantir la vérité.
Vous avez fourni la note sur Passerelle et demandé un résumé en deux phrases. La réponse commence à apparaître :
Passerelle propose des ateliers…
Que se passe-t-il à cet instant ? Le modèle a-t-il déjà rédigé le reste du paragraphe ? Cherche-t-il une phrase enregistrée dans laquelle insérer le nom de l’association ?
Dans le mécanisme que nous allons étudier, la réponse se construit progressivement. À chaque étape, le modèle calcule des possibilités pour le prochain token. Une règle de sélection en choisit un, qui est ajouté à la séquence. Le système recommence ensuite avec cette séquence prolongée.
Cette génération autorégressive est le mécanisme de nombreux LLM utilisés en conversation. Le terme signifie ici que les tokens déjà produits participent au calcul des suivants. Nous allons examiner cette boucle sans encore détailler les calculs internes du réseau : ils feront l’objet du prochain chapitre.
Le point de départ dépasse votre dernière question
Au chapitre précédent, nous avons vu comment un texte devient une séquence d’identifiants de tokens. C’est cette représentation que le modèle reçoit.
Dans une application de conversation, l’entrée peut réunir votre demande, le document à résumer, des échanges précédents et des instructions ajoutées par l’application. Le format des messages indique aussi qui parle : utilisateur, assistant ou autre rôle prévu par le système.
Le modèle ne doit donc pas nécessairement poursuivre les derniers mots de votre question comme si vous écriviez ensemble une seule phrase. Le format de conversation situe le début d’un tour de réponse de l’assistant. L’entraînement, notamment à partir d’exemples de conversation, lui a appris à produire une réponse dans ce cadre.
Dans notre exemple, les informations disponibles comprennent notamment la note sur Passerelle et la consigne de résumé. Le nom de l’association n’a pas besoin d’être connu pendant l’entraînement pour être repris dans la réponse : il figure dans la demande actuelle.
Karpathy montre comment les messages et leurs rôles deviennent une séquence destinée au modèle dans sa présentation de la conversation au moment de l’inférence, à 1 h 08 min 39 s. Les formats exacts diffèrent selon les systèmes, mais la distinction entre votre texte visible et l’entrée complète reste essentielle.
Le modèle calcule plusieurs possibilités
À une étape donnée, le modèle ne renvoie pas directement une phrase terminée. Il calcule des valeurs qui permettent d’attribuer une probabilité à chaque token de son vocabulaire pour la position suivante.
Cet ensemble est appelé une distribution de probabilités. Chaque valeur se situe entre 0 et 1, ou entre 0 % et 100 %. Additionnées sur toutes les possibilités, les probabilités donnent 1, soit 100 %. Elles décrivent les continuations possibles à partir de la séquence disponible.
Une probabilité élevée signifie donc : le modèle attribue beaucoup de poids à cette continuation dans cette situation. Elle ne signifie pas que ce token est fréquent dans tous les textes, ni qu’il sera forcément choisi.
Un tableau pour suivre une étape
Supposons que la réponse ait déjà commencé par Passerelle propose des ateliers. Voici une distribution miniature pour la suite.
Les probabilités et le découpage ci-dessous sont entièrement fictifs. Pour cet exemple pédagogique, nous supposons que chacun des fragments affichés correspond à un token. Il ne s’agit ni d’une mesure sur un LLM ni du découpage d’un tokeniseur réel. Comme au chapitre précédent, ␠ représente un espace.
| Token suivant dans l’exemple | Probabilité fictive |
|---|---|
␠gratuits | 55 % |
␠ouverts | 25 % |
␠pratiques | 10 % |
| Tous les autres tokens réunis | 10 % |
La dernière ligne regroupe de nombreuses possibilités ; ce n’est pas un token nommé « autres ». Le total du tableau est bien de 100 %.
␠gratuits est ici le token le plus probable. La note précise que la participation aux ateliers est gratuite, ce qui rend cette continuation pertinente pour notre résumé. Mais le tableau décrit une étape de génération, pas une vérification des faits.
Il serait notamment incorrect de lire « 55 % » comme « il y a 55 % de chances que les ateliers soient gratuits ». Ce nombre concerne la continuation du texte selon le modèle. La gratuité, elle, doit être établie à partir de la note ou d’une autre source fiable.
Calculer les probabilités et choisir un token sont deux opérations
Une distribution laisse plusieurs possibilités ouvertes. Pour produire une réponse précise, il faut en sélectionner une. La méthode de sélection influence donc le résultat, même lorsque le modèle et l’entrée sont identiques.
Choisir le token le plus probable
Une première méthode consiste à prendre le token ayant la probabilité la plus élevée à chaque étape. On parle de sélection gloutonne, ou greedy decoding.
Avec notre tableau, cette méthode choisit ␠gratuits. Elle ne procède pas à un tirage : elle retient le maximum de la distribution.
Le mot « gloutonne » désigne un choix local. La méthode sélectionne ce qui paraît le plus probable maintenant, sans comparer toutes les réponses complètes possibles. Ce choix ne garantit donc ni la meilleure formulation du paragraphe entier ni son exactitude.
Tirer un token selon les probabilités
Une autre méthode est l’échantillonnage, ou sampling. Elle effectue un tirage pondéré : les tokens ayant une probabilité élevée ont davantage de chances d’être choisis, mais ils ne sont pas les seuls à pouvoir l’être.
Si l’on tirait directement dans notre distribution fictive, ␠gratuits aurait 55 % de chances d’être choisi à cette étape, et ␠ouverts en aurait 25 %. Cela ne signifie pas que tous les tokens ont la même chance de sortir, ni qu’une réponse est composée au hasard sans tenir compte de la demande.
Dans les systèmes réels, des réglages peuvent modifier la distribution utilisée pour le tirage ou restreindre les candidats. La température, par exemple, peut rendre les probabilités plus concentrées ou plus étalées. Ce n’est pas un réglage de véracité : diminuer la diversité des choix ne transforme pas une affirmation fausse en information vérifiée. Nous reviendrons sur ces réglages dans le chapitre consacré aux variations des réponses.
La documentation de Hugging Face sur les stratégies de génération distingue ces méthodes de sélection. Elle les appelle des stratégies de décodage. Dans ce contexte, « décodage » désigne la manière de construire la séquence de sortie ; ce n’est pas seulement la conversion d’identifiants en texte expliquée au chapitre précédent.
Le choix effectué change l’étape suivante
Supposons que ␠gratuits soit sélectionné. Le début de réponse devient :
Passerelle propose des ateliers gratuits
Le modèle calcule alors une nouvelle distribution. Il ne réutilise pas le tableau précédent. Le texte disponible a changé, puisqu’il contient maintenant le token ajouté.
Dans une continuation possible de notre exemple, le token suivant représente un point. Le début de réponse devient alors une phrase complète :
Passerelle propose des ateliers gratuits.
Si le tirage avait retenu ␠ouverts, les possibilités suivantes auraient été différentes. Une continuation comme « à tous les étudiants » pourrait devenir pertinente sur le plan de la formulation. Il faudrait encore vérifier que cette information est justifiée par la note.
La boucle peut maintenant se résumer en quatre étapes :
- Calculer les probabilités du prochain token à partir de l’entrée et des tokens déjà produits.
- Sélectionner un token selon la méthode utilisée.
- Ajouter ce token à la séquence.
- Calculer la distribution suivante, tant qu’aucune condition d’arrêt n’est atteinte.
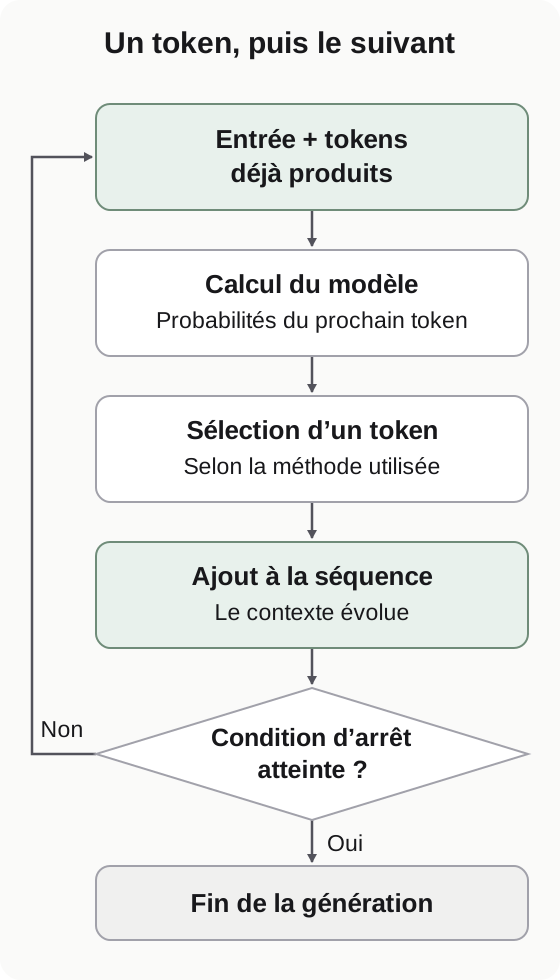
La flèche de retour représente l’ajout au contexte, pas un nouvel entraînement. Ce schéma décrit la logique de génération, sans imposer de refaire tous les calculs à chaque étape. La fin de la génération ne garantit ni une réponse complète ni une réponse vérifiée.
La section How inference works de Microsoft décrit cette boucle. Karpathy l’illustre également dans sa démonstration de l’inférence, à partir de 26 min 10 s.
Le modèle ne se limite pas au dernier mot
« Prédire le prochain token » décrit la sortie recherchée à chaque étape. Cela ne signifie pas « regarder seulement le token précédent ».
Le calcul peut dépendre de nombreux éléments encore présents dans le contexte : la consigne, le début du document, une information donnée plusieurs phrases auparavant et le début de la réponse. Dans notre exemple, « en deux phrases » reste une instruction pertinente après la première phrase.
Cette dépendance au contexte aide le modèle à produire une suite cohérente. Elle peut aussi prolonger une erreur. Si la réponse introduit un nombre incorrect, ce nombre fait désormais partie du texte disponible pour la suite. Il peut influencer la formulation des phrases suivantes, sans devenir vrai pour autant.
Générer n’est pas réentraîner le modèle
L’utilisation d’un modèle entraîné pour produire un résultat est appelée inférence. Dans le fonctionnement décrit ici, les paramètres appris restent fixes pendant la génération. Ce sont les informations de la séquence qui évoluent à mesure que des tokens s’y ajoutent.
Ainsi, si vous remplacez dans la note « six ateliers » par « huit ateliers », le modèle peut produire un résumé différent sans qu’aucun paramètre soit réentraîné. La nouvelle information modifie l’entrée du calcul.
Cela explique comment un modèle peut s’adapter à votre document immédiatement. Cela ne démontre pas qu’il conservera cette information dans ses paramètres pour une autre conversation. Les fonctions d’historique ou de mémoire d’une application constituent encore une autre question.
Karpathy distingue ces deux phases dans son explication des paramètres fixes pendant l’inférence, à 30 min 15 s. Nous examinerons plus tard comment ces paramètres ont été appris.
La boucle ne signifie pas non plus que le serveur recommence tous ses calculs depuis zéro après chaque token. Il peut conserver des résultats intermédiaires pour éviter de refaire le travail déjà effectué. Ce cache de calcul accélère la génération ; il ne constitue ni un nouvel apprentissage ni une mémoire personnelle de l’utilisateur.
Pourquoi ce mécanisme peut produire autre chose qu’une suite de mots banale
La règle de sortie est courte : prévoir un token, en sélectionner un, recommencer. Mais réussir cette prédiction dans des textes variés peut demander de représenter des relations complexes.
Pour poursuivre correctement un résumé de Passerelle, le modèle peut avoir besoin de relier un nombre à la bonne année, de distinguer l’association de ses bénévoles et de conserver une consigne donnée au début. Pour poursuivre une traduction, d’autres relations entre les langues deviennent utiles.
L’entraînement peut développer des représentations qui soutiennent ces capacités. La simplicité de la boucle de génération ne signifie donc pas que les calculs internes sont simples, ni que le modèle juxtapose seulement les mots les plus fréquents.
À l’inverse, observer une réponse réussie ne suffit pas à conclure que le modèle raisonne comme une personne. Nous pouvons expliquer le mécanisme de production sans lui attribuer une intention humaine. Les capacités de raisonnement et leurs limites auront leur propre chapitre.
Une continuation probable n’est pas une preuve
Reprenons les chiffres de notre note : 27 bénévoles l’an dernier, 41 cette année. Comparez ces deux formulations, rédigées ici pour l’exercice :
Passerelle compte maintenant 41 bénévoles, contre 27 l’an dernier.
Passerelle compte maintenant 42 bénévoles, contre 27 l’an dernier.
La deuxième phrase reste grammaticalement correcte. Son erreur ne peut pas être détectée à partir de sa seule fluidité. Il faut comparer le nombre à la note.
Le modèle a appris à produire des continuations à partir de ses données et de ses entraînements. Cela peut l’aider à rapporter correctement une information, à suivre une instruction ou à exprimer une incertitude. Mais la génération ne comporte pas, par elle-même, une consultation obligatoire d’une source indépendante pour valider chaque affirmation.
Une probabilité attribuée à un token n’est donc pas un score de confiance factuelle sur toute la réponse. De même, les expressions « certainement » ou « il est établi que » sont du texte généré ; elles ne prouvent pas qu’une vérification a eu lieu.
Cette distinction restera utile dans tout le cours : la génération produit une réponse ; la vérification établit ce qui permet de lui faire confiance. Certaines applications ajoutent une recherche ou des outils de contrôle. Leur présence et leurs limites doivent être examinées séparément.
Comment la réponse se termine-t-elle ?
Un point ne marque pas nécessairement la fin de la réponse. Dans notre demande de résumé en deux phrases, il faut encore pouvoir écrire la seconde.
Les modèles de conversation utilisent notamment des tokens particuliers pour signaler la fin d’une séquence ou d’un tour. Lorsqu’un signal de fin approprié est généré, le programme qui pilote la génération peut s’arrêter. Ce marqueur n’est généralement pas affiché comme un mot ordinaire.
La génération peut aussi s’arrêter parce qu’une limite de longueur a été atteinte, qu’une autre règle d’arrêt s’applique ou que l’exécution est interrompue. Une coupure au milieu d’une phrase ne signifie donc pas nécessairement que le modèle considérait sa réponse comme achevée. Et une réponse terminée normalement n’est pas pour autant une réponse vérifiée.
Pourquoi le texte apparaît-il progressivement ?
L’application peut transmettre les morceaux de réponse au fur et à mesure de leur production, au lieu d’attendre la fin. Cet affichage progressif est souvent appelé streaming.
Un morceau affiché ne correspond pas obligatoirement à un token : le serveur, le réseau ou l’interface peuvent regrouper plusieurs unités. Voir un mot apparaître d’un seul coup ne permet donc pas de déduire son découpage.
Dans la boucle élémentaire étudiée ici, la réponse complète n’est pas rédigée à l’avance puis révélée lettre par lettre. Des systèmes peuvent ajouter des calculs intermédiaires, des outils ou des étapes de révision, mais leur existence ne se déduit pas de la seule animation du texte à l’écran.
Vérifier votre compréhension
Reprenez le tableau des probabilités et le début de réponse sur Passerelle :
␠gratuitsa la probabilité la plus élevée. Dans quelle méthode est-il nécessairement choisi dans cet exemple ? Dans quelle méthode un autre token peut-il être retenu ?- Pourquoi faut-il calculer une nouvelle distribution après avoir ajouté
␠gratuits? Quelles informations interviennent, en plus de ce dernier token ? - La réponse annonce 42 bénévoles avec assurance. Quel élément vous permet de vérifier cette affirmation ? Pourquoi ni le ton ni la méthode de sélection ne suffisent-ils ?
- Vous modifiez la note et obtenez un résumé qui reprend le nouveau chiffre. Est-ce une preuve que les paramètres du modèle ont été réentraînés ?
Ces questions portent sur le mécanisme, pas sur la mémorisation des pourcentages fictifs. Vous pouvez y répondre sans utiliser de service d’IA.
Ce qu’il reste à ouvrir : l’intérieur du calcul
Nous pouvons maintenant suivre la construction d’une réponse : une entrée tokenisée, des probabilités conditionnées par cette entrée, un choix, puis une séquence prolongée qui sert à l’étape suivante. Cette boucle explique à la fois la progression du texte et l’influence des choix déjà effectués.
Une question demeure : comment le modèle transforme-t-il les identifiants numériques en probabilités adaptées au contexte ? Le prochain chapitre examinera les représentations apprises, les paramètres et le rôle de l’attention.
Chapitre suivant : Que se passe-t-il à l’intérieur du modèle ?
Chapitre précédent : Comment le texte devient-il des tokens ?