6. Qu’est-ce que le contexte, et de quoi le modèle se souvient-il ?
Distinguer le contexte d’une demande, les paramètres appris et la mémoire de l’application, puis comprendre les limites d’une conversation longue.
Vous avez demandé un résumé de la note de Passerelle. L’assistant a répondu. Vous écrivez ensuite :
Rends-le plus court, en gardant les deux chiffres sur les bénévoles.
Cette phrase ne contient ni le résumé à raccourcir ni les chiffres 27 et 41. Pourtant, un assistant peut produire une réponse adaptée. Comment retrouve-t-il ce dont vous parlez ? A-t-il appris votre note dans ses paramètres ?
Le chapitre précédent nous donne une première réponse : pendant l’utilisation habituelle, les paramètres ne sont pas réentraînés à chaque message. Pour comprendre la continuité d’une conversation, il faut examiner les informations que l’application rend disponibles au modèle à chaque demande.
Le contexte est ce qui est disponible pour la génération
Dans le langage courant, le contexte désigne la situation qui donne du sens à une phrase. Pour un modèle de langage, le terme a aussi un sens technique : les informations fournies au calcul pour produire la suite.
Dans le cas textuel que nous étudions, ces informations sont représentées par une séquence de tokens, avec des marqueurs qui peuvent distinguer les messages et leurs rôles. Le contexte peut comprendre votre dernière demande, mais aussi des instructions, des échanges précédents ou des documents. Les tokens déjà générés dans la réponse en cours deviennent eux aussi disponibles pour calculer les suivants.
Les connaissances acquises pendant l’entraînement jouent un autre rôle. Elles sont représentées dans les paramètres ; le corpus d’entraînement n’est pas ajouté à la demande comme un immense document. Le modèle peut ainsi utiliser des capacités apprises pour traiter une note qu’il n’a jamais rencontrée auparavant.
Karpathy propose l’image d’une mémoire de travail pour le contexte, à partir de 1 h 35 min 12 s. Elle aide à imaginer des informations disponibles pendant un travail. Mais ce n’est pas une mémoire humaine : la présence d’un passage ne garantit pas sa bonne interprétation, et cet espace ne décrit pas tout ce que l’application conserve.
Trois choses à ne pas appeler indistinctement « mémoire »
Reprenons Passerelle. Le modèle peut traiter le français grâce à son entraînement, reprendre les chiffres grâce à la note fournie et retrouver une ancienne préférence grâce à une fonction de l’application. Ces trois mécanismes sont différents.
| Élément | Rôle dans notre exemple |
|---|---|
| Paramètres appris | Contribuer aux capacités de langue, de résumé et de suivi des instructions |
| Contexte de la demande | Fournir la note de Passerelle, les chiffres et la consigne actuelle |
| Données conservées par l’application | Stocker un échange ou une préférence que l’application pourra rendre disponible plus tard |
Une information enregistrée par l’application n’influence pas automatiquement la réponse. Il faut qu’elle soit rendue accessible au calcul pertinent, par exemple en étant sélectionnée puis ajoutée au contexte. Un fichier stocké mais jamais fourni n’est pas équivalent à un passage que le modèle reçoit.
Inversement, une information peut figurer dans le contexte sans devenir un souvenir durable. Vous pouvez transmettre un chiffre pour une tâche ponctuelle ; son utilisation dans la réponse ne démontre pas qu’il a été enregistré pour les prochaines conversations.
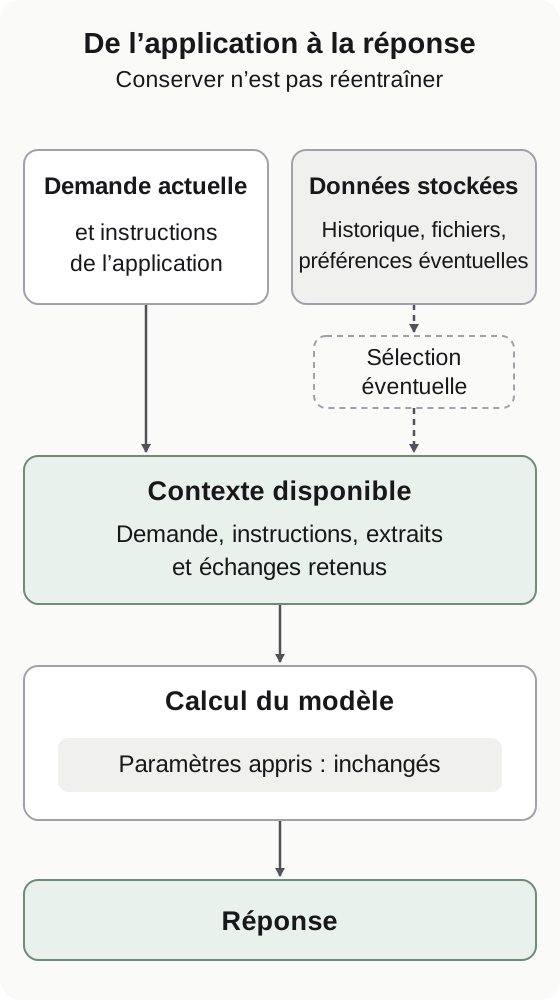
Les pointillés indiquent un apport éventuel : stocker une information ne la rend pas automatiquement disponible pour la réponse. Les paramètres sont dans le modèle ; ils ne sont pas des documents ajoutés au contexte. Les flèches décrivent les apports logiques, pas une obligation de tout retransmettre à chaque demande.
Votre message n’est souvent qu’une partie de l’entrée
L’écran montre principalement vos messages et les réponses. L’entrée préparée pour le modèle peut contenir d’autres éléments.
Les instructions de l’application, parfois placées dans un message dit système, peuvent définir le rôle attendu, la langue ou des règles de réponse. L’historique retenu peut apporter des échanges antérieurs. Des documents ou résultats d’outils peuvent fournir des informations à traiter. Selon le produit, des préférences ou des éléments de mémoire peuvent également être ajoutés.
Le mot prompt peut désigner votre demande seule ou, plus largement, l’ensemble de l’entrée préparée pour le modèle. Pour éviter la confusion, nous parlerons ici de « votre message » pour le texte saisi et de « contexte fourni » pour les éléments effectivement disponibles.
Les rôles des messages permettent de distinguer une instruction, une demande utilisateur et une réponse antérieure. Ils ne constituent pas un contrôle de vérité. Une phrase fausse contenue dans un document ou dans une ancienne réponse reste fausse, même si elle est transmise au modèle.
Microsoft décrit cette organisation dans Chat completions: the basic API pattern. Karpathy montre aussi pourquoi une page de conversation apparemment vide peut déjà comporter un message système. Une nouvelle page ne signifie donc pas forcément une entrée sans aucune instruction préalable.
Comment un deuxième tour reprend le premier
Suivons une conversation courte, dans une application qui fournit encore tout l’échange. Les formulations sont pédagogiques ; elles ne proviennent pas d’une mesure sur un service.
Au premier tour, le contexte comprend les instructions de l’application, la note de Passerelle et votre demande de résumé. Le modèle génère une réponse. L’application peut conserver cet échange.
Au deuxième tour, elle rend les éléments précédents disponibles avec votre nouvelle demande. Le calcul peut alors relier « rends-le plus court » au résumé et « les deux chiffres » à 27 et 41.
Instructions de l’application
              +
Note et première demande
              +
Première réponse de l’assistant
              +
Nouvelle demande : « Rends-le plus court… »
              ↓
Génération de la nouvelle réponse
Ce schéma décrit le contenu logique disponible, pas une obligation de tout retransmettre physiquement depuis votre navigateur. Certains services gèrent un état de conversation côté serveur. D’autres demandent à l’application de fournir les messages à chaque appel. Le moteur peut aussi réutiliser des calculs antérieurs.
La distinction reste la même : une continuité apparente peut venir de l’historique remis à disposition, sans apprentissage de nouveaux paramètres. C’est le principe présenté par Karpathy dans la construction du contexte de conversation, à 1 h 08 min 52 s.
Il faut aussi se méfier d’une ancienne erreur. Si le premier résumé a inventé une campagne sur les réseaux sociaux et que la réponse suivante se fonde sur ce résumé, l’invention peut être reprise. La répétition dans l’historique n’en fait pas une source indépendante.
S’adapter dans le contexte n’est pas réentraîner le modèle
Vous pouvez fournir un exemple de formulation, définir un terme propre à votre projet ou corriger une information. Le modèle peut utiliser ces éléments pour adapter sa réponse sans changer ses paramètres.
Cette capacité est souvent appelée apprentissage en contexte, ou in-context learning. Le mot « apprentissage » peut ici prêter à confusion : il désigne l’adaptation à partir des informations ou des exemples présents dans le contexte fourni, pas une mise à jour des paramètres pendant cette interaction.
Pour Passerelle, vous pourriez préciser :
Dans ce document, « bénévoles actifs » désigne les personnes ayant participé à au moins un atelier cette année. Utilise cette définition.
Le modèle peut appliquer cette définition dans son travail actuel. Cela ne prouve pas qu’une autre conversation recevra la même définition. Il faudra qu’elle y soit de nouveau disponible, directement ou par une fonction de mémoire de l’application.
Karpathy revient sur cette séparation entre paramètres fixes et contexte évolutif à partir de 3 h 13 min 19 s.
La fenêtre de contexte est une capacité limitée
La fenêtre de contexte désigne une limite de quantité d’information que le modèle peut prendre en compte dans une génération. Pour le texte, cette capacité se mesure en tokens, pas en nombre de messages ni directement en pages.
Dans le fonctionnement causal courant décrit ici, l’entrée et la réponse qui se construit doivent tenir dans cette capacité. Une longue note occupe de la place, mais les instructions, les anciens échanges et la nouvelle réponse aussi. Certains systèmes ont en plus une limite propre à la sortie.
La taille et les règles exactes dépendent du modèle et du service. Les images, les documents ou les étapes internes de certains modèles peuvent avoir des règles de comptage particulières. Le texte visible dans la conversation n’est donc pas toujours un inventaire complet des tokens utilisés.
Microsoft expose ce budget partagé dans How inference works. La documentation d’Anthropic sur les fenêtres de contexte fournit un exemple de mise en œuvre, avec les instructions, les messages et les résultats d’outils. Ces règles de produit ne doivent pas être généralisées à tous les services.
Un budget fictif pour voir ce qui prend de la place
Supposons une fenêtre de 10 000 tokens dans un système textuel simplifié. Tous les nombres du tableau sont inventés pour l’explication : ils ne mesurent pas nos textes et ne décrivent pas un modèle précis.
| Élément de l’entrée | Tokens dans cet exemple |
|---|---|
| Instructions et marqueurs de format | 600 |
| Échanges antérieurs retenus | 2 200 |
| Document fourni | 3 600 |
| Nouvelle demande | 400 |
| Total de l’entrée | 6 800 |
Il reste théoriquement 3 200 tokens dans cette fenêtre pour poursuivre la génération. Cela ne garantit pas une réponse de cette longueur : une limite de sortie plus basse peut s’appliquer, ou le modèle peut terminer plus tôt.
Si l’on ajoute un document de 4 000 tokens sans rien retirer, l’entrée atteint 10 800 tokens. Elle dépasse déjà notre capacité fictive, avant même de produire la réponse. Le problème ne vient pas d’un manque de volonté du modèle : l’entrée ne respecte plus les limites de ce système.
Une fenêtre plus grande permet de fournir davantage d’informations. Elle ne change pas, à elle seule, les connaissances acquises dans les paramètres et ne garantit pas que chaque passage sera utilisé correctement.
Que se passe-t-il quand la conversation devient trop longue ?
Il n’existe pas un comportement universel. Selon le service, une demande trop grande peut être refusée, une génération arrêtée à une limite, ou l’application peut adapter le contexte avant l’appel.
Elle peut notamment retirer certains anciens messages, remplacer une partie de l’échange par un résumé ou retrouver seulement les passages jugés pertinents. Ces choix peuvent intervenir avant que la fenêtre soit pleine. La compaction désigne ici une réduction du contexte, souvent par résumé, pour pouvoir poursuivre le travail avec moins de tokens.
La documentation d’Anthropic distingue la compaction du dépassement de la fenêtre. Il ne faut donc pas supposer que tous les modèles effacent automatiquement les mêmes anciens messages lorsqu’une limite est atteinte.
Surtout, l’historique affiché et le contexte utilisé peuvent diverger. Vous pouvez encore faire défiler une note à l’écran alors que la demande actuelle ne contient plus que son résumé. La conversation conservée par l’application peut être beaucoup plus longue que les informations fournies à un appel particulier.
Un résumé peut préserver le sujet et perdre la donnée utile
Voici deux résumés fictifs de la note de Passerelle :
Résumé A :
Passerelle organise des ateliers gratuits et son équipe de bénévoles s’est agrandie.
Résumé B :
Passerelle compte 41 bénévoles cette année, contre 27 l’an dernier. Elle a organisé six ateliers gratuits cette année.
Les deux conservent une partie du sens. Mais si vous demandez ensuite « de combien le nombre de bénévoles a-t-il augmenté ? », A ne fournit pas les nombres nécessaires. B permet de calculer une différence de 14 bénévoles.
Si A est la seule information restante et qu’aucun autre accès à la note n’est disponible, les nombres exacts ne peuvent pas être déduits de ce résumé. Produire une différence précise reviendrait à deviner. Le système devrait demander les données manquantes ou retrouver la source si un outil le permet.
La compaction n’agrandit donc pas la fenêtre : elle change ce qu’on y place. Un résumé peut perdre des chiffres, des dates, des exceptions ou une correction récente. Il peut aussi introduire une erreur. Il est utile, mais n’est pas une copie sans perte de toute la conversation.
Une information présente n’est pas toujours bien utilisée
Imaginons maintenant que les nombres 27 et 41 figurent bien dans le contexte. Cela ne garantit toujours pas une réponse correcte. Le modèle peut confondre les années, reprendre une ancienne version ou ne pas mobiliser le passage utile.
Il faut séparer la capacité annoncée — ce que le système accepte — de la performance sur la tâche — ce qu’il réussit à utiliser. Une entrée autorisée n’est pas une promesse de rappel parfait de chacun de ses détails.
L’étude Lost in the Middle, publiée initialement en 2023, illustre cette distinction. Dans ses tâches de réponse à des questions sur plusieurs documents et de recherche de valeurs, la position de l’information pertinente influençait les résultats. Plusieurs modèles testés réussissaient moins bien lorsque cette information se trouvait au milieu d’un long contexte.
Ce résultat porte sur les modèles et les conditions étudiés. Il ne démontre pas que tous les modèles actuels échouent toujours au milieu, ni qu’une consigne placée à la fin sera forcément respectée. Il rappelle surtout qu’une fenêtre longue doit être évaluée sur son usage réel.
La conséquence pratique n’est pas de supprimer des sources gênantes ou des contradictions. Il est préférable de fournir les documents nécessaires, de préciser les versions et de rendre la question explicite. Ajouter du texte sans rapport avec le travail peut augmenter la difficulté sans apporter d’information utile.
Comment une application peut conserver des souvenirs
Une mémoire persistante gérée par une application est un stockage qui peut survivre à une demande, voire à une conversation. Elle peut conserver des préférences, des faits extraits d’un échange ou des messages antérieurs, selon la conception du produit.
Prenons un exemple fictif. Vous indiquez : « Pour mes supports de cours, je préfère des explications en français suivies d’un exemple. » Une application dotée d’une fonction de mémoire pourrait enregistrer cette préférence. Lors d’une prochaine demande, elle pourrait la retrouver et l’ajouter aux instructions disponibles.
Le modèle peut alors adapter sa réponse parce que la préférence lui est fournie de nouveau. Il n’est pas nécessaire d’avoir réentraîné ses paramètres sur votre profil. Le stockage, la sélection du souvenir et son utilisation par le modèle sont trois opérations distinctes.
Microsoft décrit ce principe dans Adding Context Providers : l’application peut charger des éléments d’historique ou de mémoire avant une réponse, puis conserver des informations après celle-ci. Cette documentation montre une façon de construire la fonction ; elle ne prouve pas qu’elle existe ou qu’elle est activée dans chaque assistant.
Une mémoire enregistrée peut aussi être obsolète ou mal sélectionnée. Si le nombre de bénévoles a changé, retrouver une ancienne valeur ne la rend pas actuelle. Pour une donnée qui évolue, la date et la source comptent autant que la possibilité de la rappeler.
Il n’est donc pas suffisant que l’assistant écrive « je m’en souviendrai ». Cette phrase est une réponse générée. Pour savoir ce qui est réellement conservé, il faut se référer aux fonctions et aux réglages du service, ainsi qu’aux confirmations qu’il fournit pour cette opération.
Un nouveau chat ne signifie pas forcément un oubli total
Ouvrir une nouvelle conversation écarte généralement l’historique propre au fil précédent du nouvel échange. Mais l’application peut encore fournir ses instructions générales, des préférences enregistrées ou des informations associées à un projet. Le comportement exact dépend du produit.
Dans notre système simplifié, sans mémoire partagée ni récupération de documents, écrire « reprends les chiffres de Passerelle » dans un nouveau chat ne fournit pas les chiffres. Le modèle peut produire une phrase plausible, mais il ne dispose pas pour autant de la note originale. Il faut lui redonner les informations nécessaires.
Il faut aussi séparer trois questions : l’information est-elle utilisée dans cette réponse, est-elle conservée quelque part par le service, et peut-elle servir à un entraînement ultérieur ? Une réponse négative à la première ne répond pas aux deux autres.
Ni l’absence de souvenir apparent ni l’ouverture d’un nouveau chat ne prouvent une suppression des données. Avant de transmettre des données sensibles, vérifiez les règles du service et celles de votre organisation. Ce chapitre explique un mécanisme ; il ne remplace pas ces règles.
Et le cache : une autre forme de mémoire ?
Vous pouvez aussi rencontrer le mot cache. Au sens informatique, un cache conserve temporairement des éléments pour éviter de refaire un travail. Le cache de clés et de valeurs d’attention, ou KV cache, permet notamment de réutiliser certains calculs liés aux tokens précédents pendant la génération.
Il ne constitue pas, par lui-même, un carnet de souvenirs personnels ni une mise à jour des paramètres. Sa fonction est d’accélérer le calcul, pas de décider quelles informations sur vous doivent être conservées pour une prochaine conversation.
De même, la mise en cache d’un préfixe de demande ne signifie pas que ses tokens cessent d’occuper la fenêtre. La documentation d’Anthropic sur la gestion du contexte le précise pour son service. Réutiliser un calcul, conserver un historique et entraîner un modèle sont des opérations différentes, même si chacune implique du stockage informatique.
Préparer une continuité fiable pour votre travail
Pour un travail prolongé sur Passerelle, vous pouvez conserver une courte note de référence : la version actuelle des données, la tâche, les contraintes et les points encore incertains. Ce document vous appartient ; il ne dépend pas d’une promesse de mémoire de l’assistant.
Avant une étape importante, fournissez ou vérifiez les éléments indispensables. Si les chiffres ont été corrigés, indiquez clairement quelle version remplace l’ancienne. Si vous ouvrez un nouveau chat, joignez la note nécessaire plutôt que de supposer que l’ancien échange sera disponible.
Vous pouvez demander à l’assistant de reformuler les données qu’il va utiliser. Comparez ensuite cette reformulation à la source. C’est un contrôle du résultat produit, pas une inspection complète du contexte interne de l’application. Une affirmation comme « j’ai bien tout lu » ne remplace pas cette vérification.
Le but n’est pas de répéter toute la conversation à chaque message. Il est de rendre les informations décisives disponibles, à jour et vérifiables, sans dépendre d’un souvenir implicite.
Vérifier votre compréhension
- Pourquoi « rends-le plus court » peut-il suffire dans une conversation, mais être insuffisant dans un nouveau chat sans mémoire partagée ?
- Dans notre fenêtre fictive de 10 000 tokens, pourquoi les 3 200 tokens restants ne garantissent-ils pas une réponse de cette longueur ?
- Si le résumé A remplace la note complète de Passerelle, quelle information manque pour calculer l’augmentation du nombre de bénévoles ? Le fait que l’ancienne note soit encore visible à l’écran résout-il nécessairement ce problème ?
- Quelle différence y a-t-il entre une préférence apprise pendant un entraînement et une préférence enregistrée par l’application puis fournie dans le contexte ?
- Une réponse oublie une donnée. Pourquoi cela ne suffit-il pas à conclure que la fenêtre était pleine ou que le service a supprimé cette donnée ?
Vous pouvez traiter ces questions à partir des exemples, sans utiliser un service d’IA. Essayez de justifier vos réponses en distinguant ce qui est appris, ce qui est stocké et ce qui est effectivement disponible pour la génération.
La prochaine question : pourquoi les réponses varient-elles ?
Deux demandes qui paraissent identiques à l’écran ne sont pas forcément accompagnées du même contexte. Les instructions, l’historique retenu ou les documents fournis peuvent différer.
Mais même avec un contexte identique, la réponse peut varier. Le prochain chapitre distinguera la méthode de sélection des tokens, ses réglages et les conditions d’exécution du modèle.
Chapitre précédent : Comment le modèle apprend-il, puis devient-il un assistant ?
Chapitre suivant : Pourquoi la même question peut-elle produire des réponses différentes ?